Java性能 -- JIT
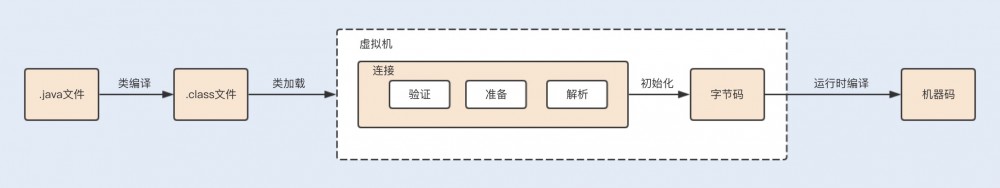
- 前端编译 :即常见的 .java文件 被编译成 .class文件 的过程
- 运行时编译 :机器无法直接运行Java生成的字节码,在 运行时 , JIT 或者 解释器 会将 字节码 转换为 机器码
- 类文件在运行时被进一步编译,可以变成 高度优化 的机器代码
- C/C++编译器的所有优化都是在 编译期 完成的,运行期的性能监控仅作为基础的优化措施是无法进行的
- JIT编译器 是JVM中 运行时编译 最重要的部分之一
编译 / 加载 / 执行
类编译
- javac :将.java文件 编译 成.class文件
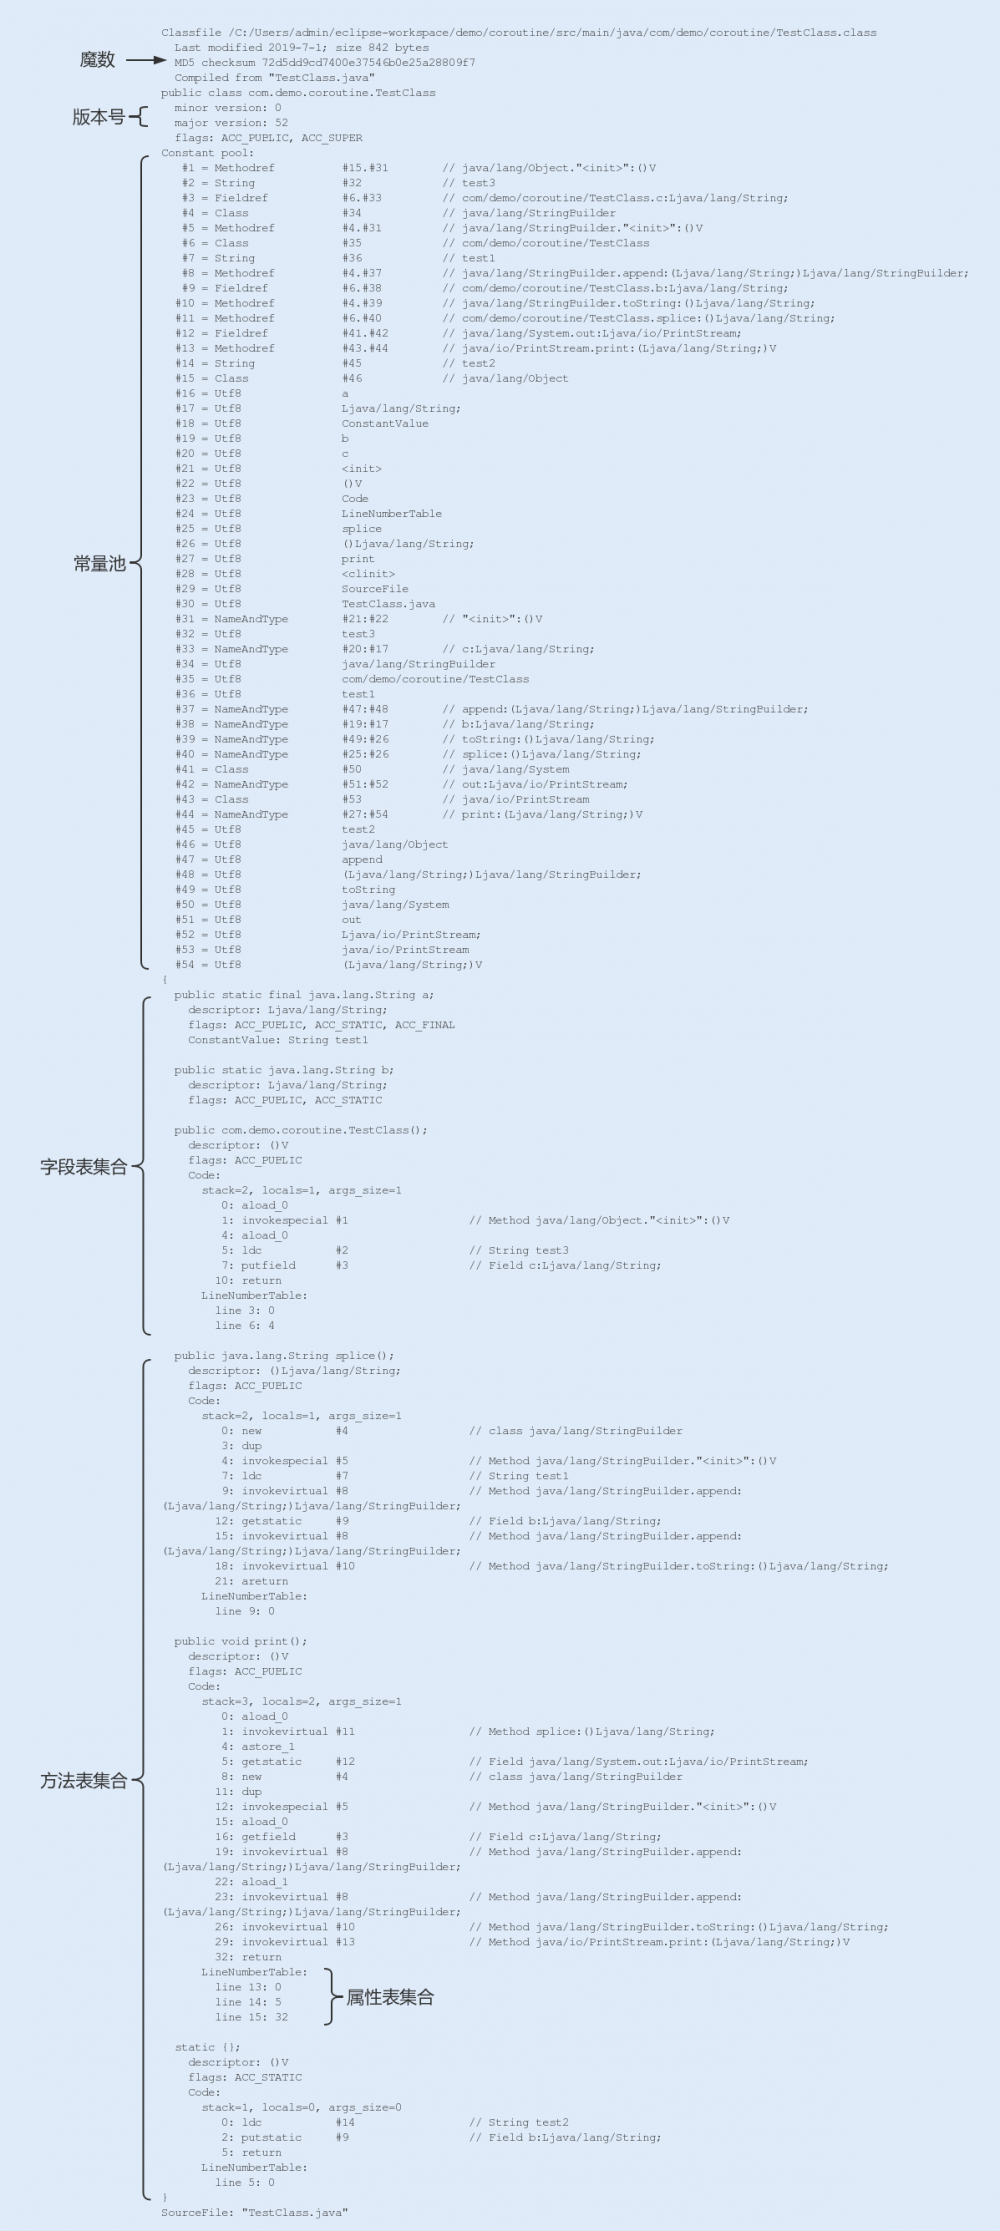
- javap : 反编译 .class文件,重点关注 常量池 和 方法表集合
- 常量池主要记录的是类文件中出现的 字面量 和 符号引用
- 字面量: 字符串常量 、 基本类型的常量
- 符号引用: 类和接口的全限定名 、 类引用 、 方法引用 、 成员变量引用
- 方法表集合
- 方法的字节码、方法访问权限、方法名索引、描述符索引、JVM执行指令、属性集合等
- 常量池主要记录的是类文件中出现的 字面量 和 符号引用
类加载
- 当一个类 被创建实例 或者 被其他对象引用 时,JVM如果没有加载过该类,会通过 类加载器 将 .class文件 加载到 内存 中
- 不同的实现类由不同的类加载器加载
- JDK中的本地方法类 一般由根加载器( Bootstrap Loader )加载
- JDK中内部实现的扩展类 一般由扩展加载器( ExtClassLoader )加载
- 程序中的类文件 则由系统加载器( AppClassLoader )加载
- 在类加载后,.class类文件中的 常量池信息 以及其他数据会被保存到JVM内存的 方法区 中
类连接
- 类在加载进内存后,会进行 连接、初始化 ,最后才能被使用,连接又包括 验证 、 准备 、 解析 三部分
- 验证
- 验证类 符合JVM规范 ,在保证符合规范的前提下, 避免危害虚拟机安全
- 准备
- 为类的静态变量分配内存 ,初始化为 系统的初始值
- 对于
final static修饰的变量, 直接赋值 为用户的定义值-
private final static int value = 123,会在准备阶段分配内存,并初始化值为 123 -
private static int value = 123,会在准备阶段分配内存,并初始化值为 0
-
- 解析
- 将 符号引用 转为 直接引用
- 在 编译 时,Java类 并不知道 所引用的类的 实际地址 ,因此只能使用符号引用来代替
- .class文件的常量池 中存储了 符号引用 ,实际使用时,需要将它们转化为 JVM能直接获取的内存地址或指针
类初始化
- 类初始化是类加载过程的最后阶段,首先执行构造器
<clinit>方法 - 前端编译时( javac ),收集所有的 静态变量赋值语句 、 s 静态代码块 、 静态方法 ,成为
<clinit>**方法 - 初始化类的 静态变量 和 静态代码块 均为用户自定义的值,初始化顺序和Java源码 从上到下 的顺序一致
- 子类初始化时,会先调用 父类 的
<clinit>方法,再调用子类的<clinit>方法 - JVM会保证
<clinit>方法的 线程安全 ,保证同一时间只有一个线程执行 - JVM在 实例化新对象 时,会调用
<init>方法对 实例变量 进行初始化,并执行对应的构造方法内的代码
即时编译
- 初始化完成后,类在调用执行过程中,执行引擎需要把 字节码 转换为 机器码 ,然后才能在 操作系统 中执行
- 在字节码转换为机器码的过程中,虚拟机还存在着一道编译,那就是 即时编译
- 起初,虚拟机中的字节码是由 解释器 (Interpreter)完成编译的
- 当虚拟机发现某个方法或者代码块运行得特别频繁的时候,就会把这些代码认定为 热点代码
- 为了提高热点代码的 执行效率 , JIT 会把热点代码编译成 与本地平台相关的高度优化的机器码 ,然后保存在 内存 中
即时编译类型
- 在 HotSpot VM 中,内置了两个JIT,分别是 C1 编译器( Client Compiler)和 C2 编译器( Server Compiler)
- C1 编译器是一个 简单快速 的编译器,主要的关注点在于 局部性 的优化,适用于 执行时间较短 或 对启动速度有要求 的程序
- C2 编译器是为 长期运行 的 服务器端 应用程序做性能调优的编译器,适用于 执行时间较长 或 对峰值性能有要求 的程序
- 在Java 7之前,需要根据 应用的特性 来选择对应的JIT,虚拟机默认采用 解释器 和其中一个 即时编译器 配合工作
- Java 7引入了分层编译 ,综合了 C1的启动性能优势 和 C2的峰值性能优势
- 也可以通过参数
-client、-server强制指定虚拟机的 即时编译模式 - 分层编译是将 JVM的执行状态 分了5个层次
- 第0层
- 程序解释执行,默认开启Profiling(如果不开启,可触发第2层编译)
- 第1层
- 称为C1编译,将字节码编译为本地代码,进行 简单可靠 的优化,不开启Profiling
- 第2层
- 称为C1编译,开启Profiling,仅执行带 方法调用次数 和 循环回边执行次数 Profiling的C1编译
- 第3层
- 称为C1编译,开启Profiling,执行 所有 带Profiling的C1编译
- 第4层
- 称为C2编译,将字节码编译为本地代码
- 但会启用一些 编译耗时较长 的优化,甚至会根据性能监控信息进行一些 不可靠的激进优化
- 也可以通过参数
- Java 8 默认开启分层编译 ,参数
-client、-server已失效- 如果 只想开启C2 ,可以 关闭分层编译
-XX:-TieredCompilation - 如果 只想开启C1 ,可以 打开分层编译 ,并且使用参数
-XX:TieredStopAtLevel=1
- 如果 只想开启C2 ,可以 关闭分层编译
- 单一编译模式 (上面的都是 混合编译 模式)
-
-Xint- 强制虚拟机运行于 只有解释器的编译模式下 , JIT完全不介入工作
-
-Xcomp- 强制虚拟机运行于 只有JIT的编译模式下
-
$ java -version
openjdk version "1.8.0_222"
OpenJDK Runtime Environment (Zulu 8.40.0.25-CA-macosx) (build 1.8.0_222-b10)
OpenJDK 64-Bit Server VM (Zulu 8.40.0.25-CA-macosx) (build 25.222-b10, mixed mode)

$ java -Xint -version
openjdk version "1.8.0_222"
OpenJDK Runtime Environment (Zulu 8.40.0.25-CA-macosx) (build 1.8.0_222-b10)
OpenJDK 64-Bit Server VM (Zulu 8.40.0.25-CA-macosx) (build 25.222-b10, interpreted mode)

$ java -Xcomp -version
openjdk version "1.8.0_222"
OpenJDK Runtime Environment (Zulu 8.40.0.25-CA-macosx) (build 1.8.0_222-b10)
OpenJDK 64-Bit Server VM (Zulu 8.40.0.25-CA-macosx) (build 25.222-b10, compiled mode)
热点探测
- HotSpot VM的热点探测是JIT优化的条件,热点探测是基于 计数器 的热点探测
- 采用这种方法的虚拟机会为每个方法建立 计数器 统计方法的执行次数
- 如果执行次数超过一定的 阈值 就认为是热点方法
- 虚拟机为 每个方法 准备了两类计数器: 方法调用计数器 (Invocation Counter)、 回边计数器 (Back Edge Counter)
- 在确定虚拟机运行参数的前提下,这两个计数器都有一个 明确的阈值 ,当计数器 超过阈值 ,就会触发 JIT编译
- 方法调用计数器
- C1 模式下是 1500 次, C2 模式下是 10000 次,可通过参数
-XX:CompileThreshold来设置 - 在 分层编译 的情况下,参数
-XX:CompileThreshold将 失效- 将会根据当前 待编译的方法数 以及 编译线程数 来 动态调整
- 当方法计数器和回边计数器 之和 超过 方法计数器阈值 时,触发 JIT编译
- C1 模式下是 1500 次, C2 模式下是 10000 次,可通过参数
- 回边计数器
- 用于统计一个方法中 循环体 代码执行的次数( 回边 :字节码中遇到控制流 向后跳转 的指令)
- 不开启分层编译时, C1 默认为 13995 , C2 默认为 10700 ,可通过参数
-XX:OnStackReplacePercentage来设置 - 在 分层编译 的情况下,参数
-XX:OnStackReplacePercentage同样会 失效- 将会根据当前 待编译的方法数 以及 编译线程数 来 动态调整
- 建立回边计数器的主要目的是为了触发 OSR (On Stack Replacement)编译,即 栈上编译
- 在一些 循环周期比较长 的代码段中,当循环达到回边计数器阈值时,JVM会认为这段代码是 热点代码
- JIT编译器会将这段代码编译成 机器语言 并 缓存 ,在该循环时间内, 直接替换 执行代码, 执行缓存的机器语言
编译优化技术
方法内联
- 调用一个方法通常要经历 压栈 和 出栈
- 调用方法是将程序执行顺序转移到存储该方法的内存地址,将方法的内容执行完后,再返回到执行该方法前的位置
- 方法调用会产生一定的 时间开销 和 空间开销 ,对于 方法体代码不是很大 ,又 频繁调用 的方法来说,这个 开销会很大
- 方法内联: 把目标方法的代码复制到发起调用的方法中,避免发生真实的方法调用
- JVM会 自动识别 热点方法,并对它们使用 方法内联 进行优化,可以通过
-XX:CompileThreshold来设置热点方法的阈值 - 热点方法 不一定 会被JVM做内联优化,如果 方法体太大 ,JVM将不执行内联操作
- 经常执行 的方法,默认情况下,方法体大小 小于325字节 的都会进行内联,参数
-XX:MaxFreqInlineSize - 不经常执行 的方法,默认情况下,方法体大小 小于35字节 的才会进行内联,参数
-XX:MaxInlineSize
- 经常执行 的方法,默认情况下,方法体大小 小于325字节 的都会进行内联,参数
- 提高 方法内联 的方式
- 减少
-XX:CompileThreshold,增加-XX:MaxFreqInlineSize或-XX:MaxInlineSize - 避免在一个方法中写大量代码,习惯使用 小方法体
- 尽量使用 private 、 static 、 final 关键字 修饰方法 ,编码方法因为 继承 ,会需要 额外的类型检查
- 减少
-XX:+UnlockDiagnosticVMOptions  // 解锁对 JVM 进行诊断的选项参数。默认是关闭的,开启后支持一些特定参数对 JVM 进行诊断
-XX:+PrintCompilation           // 在控制台打印编译过程信息
-XX:+PrintInlining              // 将内联方法打印出来
private static int add1(int x1, int x2, int x3, int x4) {
    return add2(x1, x2) + add2(x3, x4);
}

private static int add2(int x1, int x2) {
    return x1 + x2;
}

public static void main(String[] args) {
    // 方法调用计数器的默认阈值在C1模式下是1500次,在C2模式在是10_000次
    for (int i = 0; i < 1_000_000; i++) {
        add1(1, 2, 3, 4);
    }
}
377   21       4       Test::add1 (12 bytes)
                            @ 2   Test::add2 (4 bytes)   inline (hot)
                            @ 7   Test::add2 (4 bytes)   inline (hot)
...
384   24 %     4       Test::main @ 2 (23 bytes)
                            @ 12   Test::add1 (12 bytes)   inline (hot)
                              @ 2   Test::add2 (4 bytes)   inline (hot)
                              @ 7   Test::add2 (4 bytes)   inline (hot)
逃逸分析
逃逸分析是判断一个对象是否被 外部方法引用 或 外部线程访问 的分析技术,编译器会根据逃逸分析的结果对代码进行优化
栈上分配
- 在Java中默认创建一个对象是在 堆 上分配内存的,当堆内存中的对象不再使用时,会被垃圾回收
- 这个过程相对分配在 栈 上的对象的创建和销毁来说,更耗 时间 和 性能
- 逃逸分析如果发现 一个对象只在方法中使用 ,就会将对象分配在 栈 上
- HotSpot VM暂时没有实现这项优化
锁消除
- 在局部方法中创建的对象只能被 当前线程 访问,无法被其他线程访问,JIT会对该对象的方法锁进行 锁消除
标量替换
- 逃逸分析证明一个对象 不会被外部访问
- 如果该对象可以被 拆分 的话,当程序真正执行的时候,可能不会创建这个对象,而是直接创建它的 成员变量 来代替
- 将对象拆分后,可以分配对象的 成员变量 在 栈 或 寄存器 上,原本的对象就无需分配内存空间了,称为 标量替换
public void foo() {
    TestInfo info = new TestInfo();
    info.id = 1;
    info.count = 99;
}
逃逸分析后,代码被优化
public void foo() {
    id = 1;
    count = 99;
}
JVM参数
-XX:+DoEscapeAnalysis 开启逃逸分析(JDK 1.8默认开启)
-XX:+EliminateLocks 开启锁消除(JDK 1.8默认开启)
-XX:+EliminateAllocations 开启标量替换(JDK 1.8默认开启)
正文到此结束
热门推荐




相关文章



Loading...


