注解 限流,怎么实现
一个问题往往会引出了一连串的问题,知识的盲区就这样被自己悄悄的发现了 。 车辙在自己动手写 限流注解 时,遇到的问题那是真一个比一个多:
or
实践
什么是限流
对服务器接收到的请求作出限制,只有一部分请求能真正到达服务器,其他的请求可以延迟,也可以拒绝。从而避免所有请求到数据库,打垮DB。
举个生活中大家可能遇到的场景,特别是北上广深或者新一线城市,杭州一号线地铁,凤起路站,在客流量到达一定峰值时,警察叔叔:cop:♀可能就不让你进地铁,让使用其他交通工具了️。。。都是泪啊
限流算法用哪个比较合适
关于限流算法,网上的解释一大堆,漏桶算法,令牌桶算法等等, 百度一下,你就知道 ,在这里车辙用最简单的计数器算法作为实现。
计数器算法
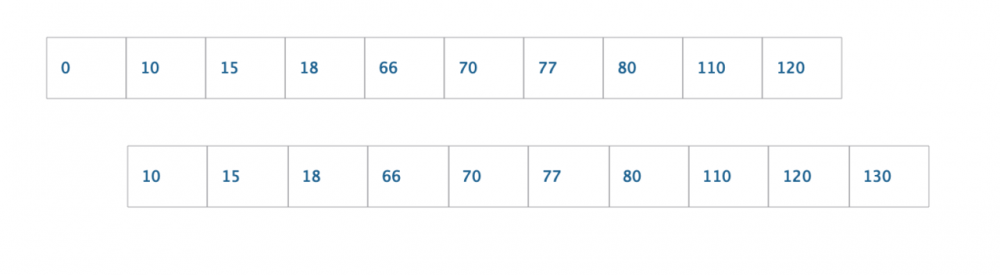
- 将一秒钟分为10个阶段,每个阶段100ms。
- 每隔100ms记录下接口调用的次数。
- 当然随着时间的流逝,阶段会越来越多。这时候可以将最前面的n个阶段删除,只保留10个,也就是只剩1s。
- 最后一个减去第一个的次数,就是1s中内该接口调用的次数
如何用注解实现限流
在用 nginx 限流时,是将 nginx 作为代理层拦截请求,处理,那么在 Spring 中代理层就是 AOP 啦
AOP
在web服务器中,有很多场景都是可以靠AOP实现的,比如
- 打印日志,记录时间类,方法,参数
- 利用反射设置分页PageRow,PageNum的默认值
- 游戏场景,判断游戏是否已经结束,不用每个方法都去判断
- 解密,验签等等
定时任务
在计数器算法中我们提到,每隔100ms需要记录接口调用的次数,并保存。这时候定时任务就派上用场了。
定时任务的实现有很多,像利用线程池的 ScheduledExecutorService ,当然 Spring 的 Scheduled 也莫得问题。
其次,用什么数据结构保存调用次数 -->LinkedList。
另外,我们需要对多个方法限流,该如何解决呢?-->每个方法都有唯一对应的值: package + class + methodName ,于是我们将这个唯一值作为key,linkedList作为map,下方代码
/** 每个key 对应的调用次数**/
    private Map<String, Long> countMap = new ConcurrentHashMap<>();

    /** 每个key 对应的linkedlist**/
    private static Map<String, LinkedList<Long>> calListMap = new ConcurrentHashMap<>();

    ## 每s一次查询
    @Scheduled(cron = "*/1 * * * * ?")
    private void timeGet(){
        countMap.forEach((k,v)->{
            LinkedList<Long> calList = calListMap.get(k);
            if(calList == null){
                calList = new LinkedList<>();
            }
            # 每个方法的调用次数放入linkedList中
            calList.addLast(v);
            calListMap.put(k, calList);

            if (calList.size() > 10) {
                calList.removeFirst();
            }
        });
    }
复制代码
AOP检查
定义注解
import java.lang.annotation.*;


@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
@Documented
public @interface CalLimitAnno {

    String value() default "" ;

    String methodName() default "" ;

    long count() default 100;
}
复制代码
调用接口前检查
@Around(value = "@annotation(around)")
    public Object initBean(ProceedingJoinPoint point, CalLimitAnno around) throws Throwable {
        /** 获取类名和方法名 **/
        MethodSignature signature = (MethodSignature) point.getSignature();
        Method method = signature.getMethod();
        String[] classNameArray = method.getDeclaringClass().getName().split("//.");
        String methodName = classNameArray[classNameArray.length - 1] + "." + method.getName();
        String classZ = signature.getDeclaringTypeName();
        String countMapKey =  classZ + "|" + methodName;


        LinkedList<Long> calList = calListMap.get(countMapKey);
        if(calList != null){
            /** 调用次数判断是否已经超过注解设置的值 **/
            if ((calList.peekLast() - calList.peekFirst()) > Long.valueOf(around.count())) {
                throw new RuntimeException("被限流了");
            }
            /** 存放**/
            countMap.putIfAbsent(countMapKey,0L);
            countMap.put(countMapKey,countMap.get(countMapKey) + 1);
        }
        Object object = point.proceed();
        return object;
    }
复制代码
方法
考虑到定时任务的频率不能太小,因此我们的定时任务是每秒钟执行一次,这里我们需要设置10s钟的限流值,导致粒度变大了。
@CalLimitAnno(count = 1000)
    public void testPageAnno(){
        System.out.println("成功执行");
    }
复制代码
Map优化
上述我们将 package + className + methodName 作为唯一key,导致key的长度变得特别长,我们是不是该想个办法降低key的长度。
有些同学会想到压缩,但这根本是不现实的,具体原因见 链接 。
这也不能用,那也不能用,还让不让人活了 。大家有没有想到平时收到的短信,有时候会存在一个短链接,这些短连接其实就是用的发号器--> 从某个服务中获取唯一的自增id,然后将这个id进行转化。比如这时候自增到100000了,那么将100000从十进制转化为62进制 q0U 。这个和短信上的链接很相似不是吗?
Map持久化
既然是自增的,那么相同的长字符通过调用服务转化成的短字符串都是不同的。在某些业务场景,可能调用比较频繁,就需要做kv存储。不然也没有必要做存储了,多做多错嘛~
kv存储优化
假设我们需要做kv存储,童鞋们能想到的大概也就是 jvm 内存或者 redis 了。因为这个对应关系一般是不会长久存储的,通常在某个热点事件中作为查询。如果是 redis ,可以设置过期时间作为驱逐。那么在 jvm 内存中,我们需要考虑到的是 LRU 。即最近最常使用
- 使用过的key需要放到队列的队首
- 最不经常使用的一旦超过队列限制的长度,需要将其删除。
那么我们需要用哪种数据结构实现这中条件的队列呢?
GET
- 假设这个key不存在,那么返回null
- 假设key存在,需要返回值的同时,需要将对应的key删除,并且将key放到队首。
在上述的这种场景下,明显底层是数组的集合如ArrayList是不适用的。别说你这想不通哈。。
那就只剩下链表了如LinkedList,但是LinedList查询时需要遍历链表。如果我们在存入LinkedList的同时,同样存入map,那是不是就行了。当然。。。。不是啦,这个 map 有个要求, node 需要保存上一个节点。这样在查到值的同时,获取前一个节点,就可以在链表中删除对应的节点了
PUT
- 假设key不存在,放入队首
- 假设key存在,删除这个key,同时放到队首
经过 Get 的铺垫,这个不用说了吧
最终结果:LinedHashMap
LinkedHashMap 的具体车辙这边就不逼逼了,还是 百度一下,你就知道
结尾
这边不考虑并发导致的线程不安全哈,只是一个参考~~~
讲了大半天,大家应该还是有些会看不明白的,请下方留言。没办法,语文差啊:joy:。
正文到此结束
- 本文标签: 数据库 LinkedList 遍历 DDL db AOP UI 并发 list java 线程池 地铁 ConcurrentHashMap 时间 src node IO map 限流 value spring ACE tar HashMap 代码 百度 服务器 executor 安全 JVM key 删除 id redis 参数 Nginx bean 线程 ArrayList Document http https 短连接 数据 分页 web Service
- 版权声明: 本文为互联网转载文章,出处已在文章中说明(部分除外)。如果侵权,请联系本站长删除,谢谢。
- 本文海报: 生成海报一 生成海报二
热门推荐




相关文章



Loading...


