[JVM系列]三、一文搞懂JVM垃圾回收
- System.gc() 发出一个信号,告知JVM需要垃圾回收了,具体啥时候回收,由JVM决定,不建议手动调用这个方法,因为垃圾回收会占用CPU资源,回收次数越少越好。
- Eden或S区不够用了 (新生代的GC 称为Young GC 或 Minor GC)
- 老年代不够用了
- Metaspace(方法区)不够用了 (Metaspace GC)
Full GC=Metaspace GC+Young GC+old GC (全局GC)
Full GC : 一般是由Old区引起的,由于老年代的的对象通常会比较多,因为标记 - 清理 - 整理(压缩)的耗时通常会比较长,会让应用出现卡顿的现象,这也是为什么很多应用要优化,尽量避免或减少 Full GC 的原因。
怎么回收?
用合适的 垃圾搜集算法 进行回收,一般有如下几个算法:
1. 标记-清除(Mark-Sweep)
- 标记 :找出内存中需要回收的对象,并且把它们标记出来
此时堆中所有的对象都会被扫描一遍,从而才能确定需要回收的对象,比较耗时
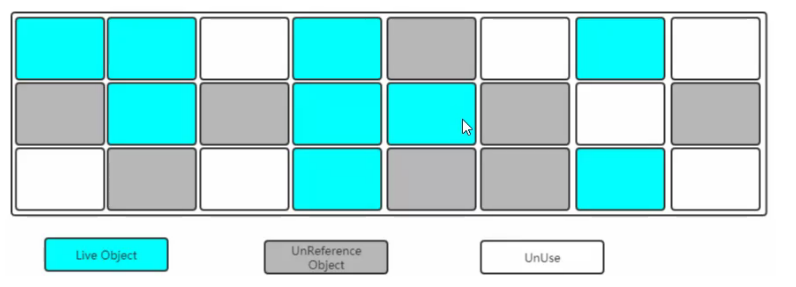
- 清除 :清除掉被标记需要回收的对象,释放出对应的内存空间
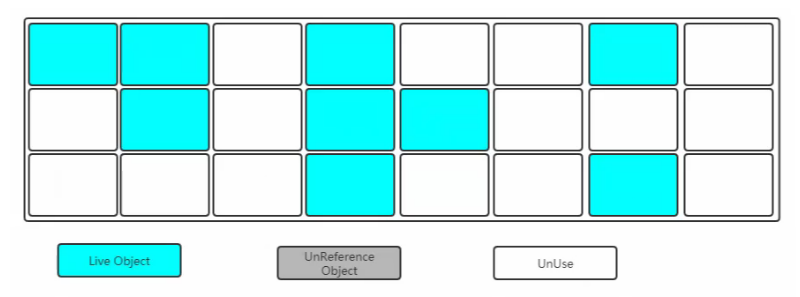
缺点:
- 标记和清除两个过程都比较耗时,效率不高
- 会产生大量不连续的内存碎片,空间碎片太多可能会导致以后在程序运行过程中需要分配较大对象时,无法找到足够的连续内存而不得不提前触发另一次垃圾收集动作。
2. 标记-复制
将内存划分为两块相等的区域,每次只使用其中一块,如下图所示:
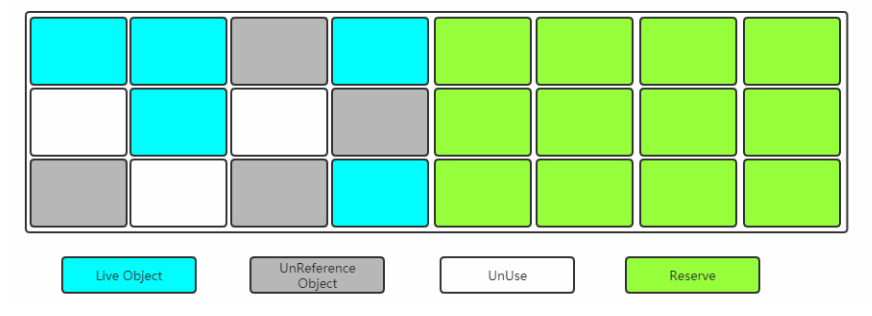
当其中一块内存使用完了,就将还存活的对象复制到另外一块上面,然后把已经使用过的内存空间一次清除掉。
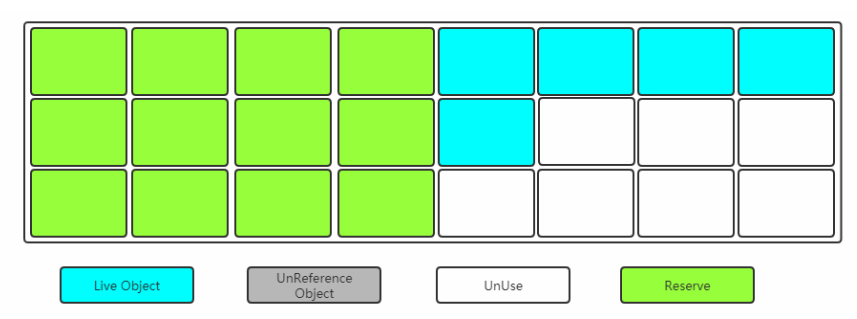
标记复制算法适用于新生代,因为它快
缺点:空间利用率降低。
3. 标记-整理
标记复制收集算法在对象存活率较高时就要进行较多的复制操作,效率将会变低。更关键的是,如果不想浪费50%的空间,就需要有额外的空间进行分配担保,以应对被使用的内存中所有对象都有100%存活的极端情况,所以老年代一般不能直接选用这种算法。
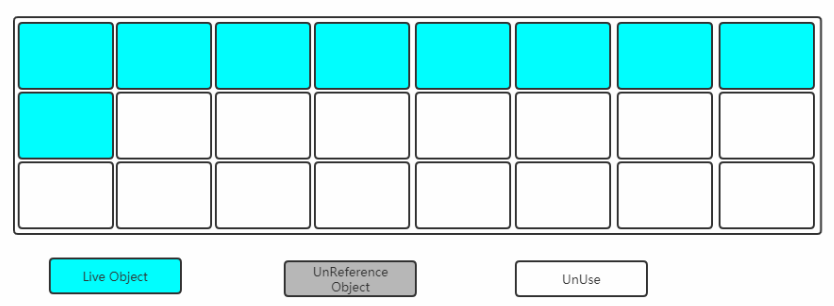
标记过程仍然与"标记-清除"算法一样,但是后续步骤不是直接对可回收对象进行清理,而是让所有存活 的对象都向一端移动,然后直接清理掉端边界以外的内存。
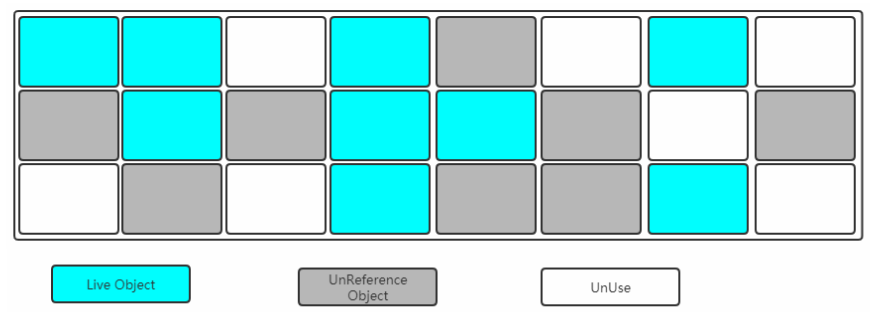
让所有存活的对象都向一端移动,清理掉边界意外的内存。
总结:
- 标记-回收 优点:算法简单 缺点:耗时,因为要扫描整个内存空间,且会产生空间碎片。
- 标记-整理 优点:不会产生空间碎片,能有大段空白的内存空间 缺点:算法麻烦复杂,且执行耗时
- 标记-复制 优点:用空间换时间,速度快。 缺点:因为用空间换时间,所以空间利用率较低
- young区适用于标记赋值算法(对象在被分配之后,可能生命周期比较短,Young区复制效率比较高)
- old区适用于标记清除或标记整理(Old区对象存活时间比较长,复制来复制去没必要,不如做个标记再清理)
垃圾收集器
如果说收集算法是内存回收的方法论,那么垃圾收集器就是内存回收的具体实现。
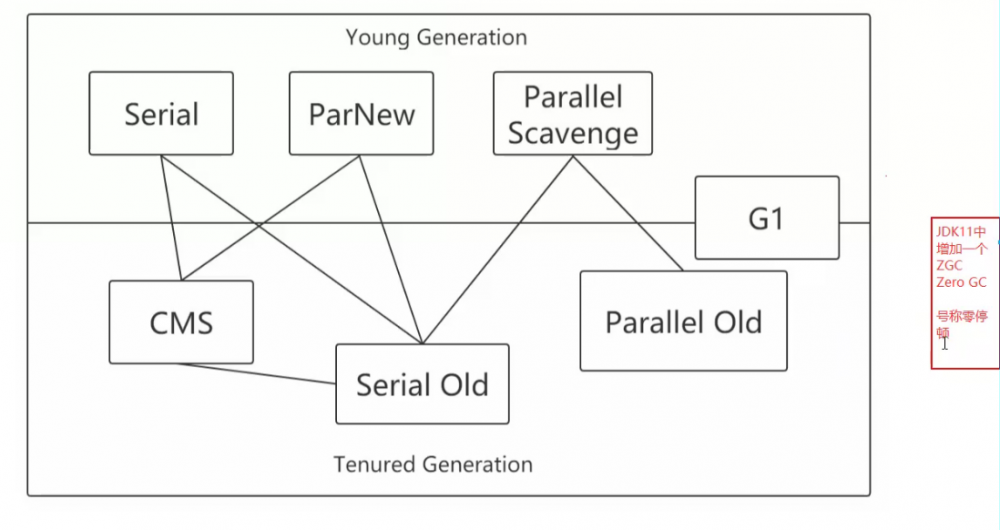
1. Serial
Serial收集器是最基本、发展历史最悠久的收集器,曾经(在JDK1.3.1之前)是虚拟机新生代收集的唯 一选择。
它是一种 单线程 收集器,不仅仅意味着它只会使用一个CPU或者一条收集线程去完成垃圾收集工作,更重要的是其在进行垃圾收集的时候需要暂停其他线程。
- 优点:简单高效,拥有很高的单线程收集效率
- 缺点:收集过程需要暂停所有线程
- 算法:复制算法
- 适用范围:新生代
- 应用:Client模式下的默认新生代收集器
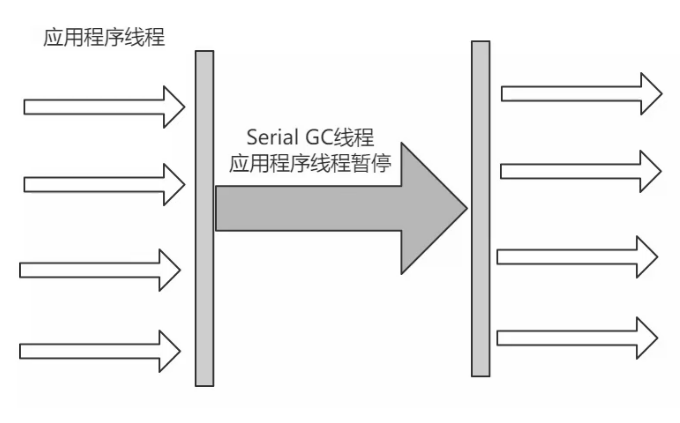
2. Serial Old
Serial Old收集器是Serial收集器的老年代版本,也是一个单线程收集器,不同的是采用" 标记-整理算法 ",运行过程和Serial收集器一样。
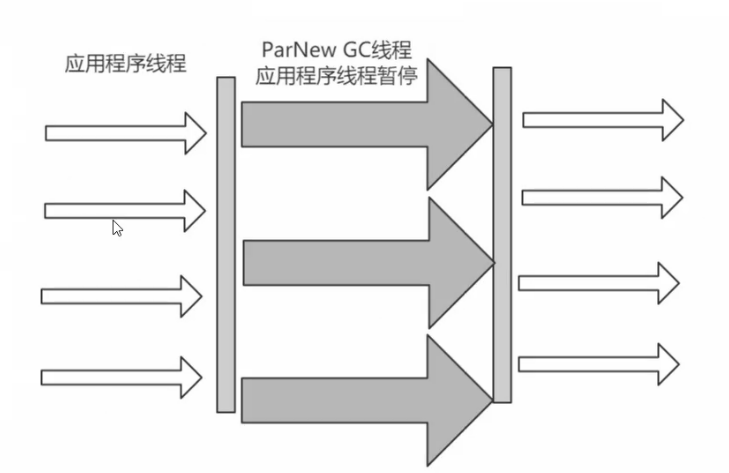
3. ParNew
其实就是 Serial 的 多线程 版本。和ParallelScanvenge一样都是新生代的垃圾收集器
- 优点:在多CPU时,比Serial效率高。
- 缺点:收集过程暂停所有应用程序线程,单CPU时比Serial效率差。
- 算法:复制算法
- 适用范围:新生代
- 应用:运行在Server模式下的虚拟机中首选的新生代收集器
4. Parallel Scavenge
Parallel Scavenge收集器是一个新生代收集器,它也是使用 复制算法 的收集器,又是并行的 多线程 收集器,看上去和ParNew一样,但是Parallel Scanvenge更关注系统的 吞吐量 。
吞吐量=运行用户代码的时间/(运行用户代码的时间+垃圾收集时间)
若吞吐量越大,意味着垃圾收集的时间越短,则用户代码可以充分利用CPU资源,尽快完成程序 的运算任务。
5. Parallel Old
Parallel Old收集器是Parallel Scavenge收集器的老年代版本,使用 多线程 和 标记-整理算法 进行垃圾回收,也是更加关注系统的吞吐量。
5. CMS
Concurrent Mark Sweep-用于老年代的垃圾收集器
官网: docs.oracle.com/javase/8/do…
前面的垃圾收集器都是stop the world,能不能少一点呢?能不能业务代码线程和垃圾回收线程一起跑?
CMS初衷:为了尽可能减少stw的时间,追求一个停顿时间比较低的垃圾收集,它会更 关注停顿时间 。
但也不能全程一起跑,不能一边生成垃圾,一边回收垃圾,一定有垃圾收集器有自己跑的时候。
CMS采用的是标记清除算法,整个过程分为4步
- 初始标记 CMS initial mark 标记GC Roots直接关联对象,不用Tracing,速度很快
- 并发标记 CMS concurrent mark 进行GC Roots Tracing
- 重新标记 CMS remark 修改并发标记因用户程序变动的内容
- 并发清除 CMS concurrent sweep 清除不可达对象回收空间,同时有新垃圾产生,留着下次清理称为 浮动垃圾
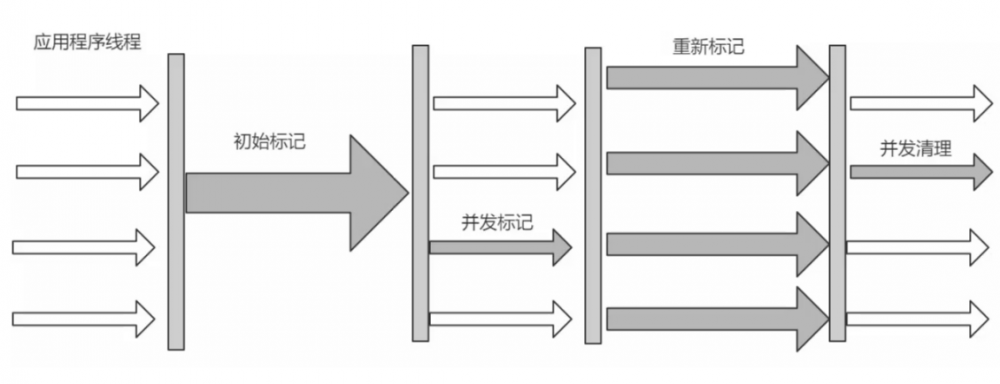
由于整个过程中,并发标记和并发清除,收集器线程可以与用户线程一起工作,所以总体上来 说,CMS收集器的内存回收过程是与用户线程一起并发地执行的。
CMS 缺点:
1. 对 CPU 资源要求敏感。
CMS 回收器过分依赖于多线程环境,默认情况下,开启的线程数为(CPU 的数量 + 3)/ 4,当 CPU 数量少于 4 个时,CMS 对用户本身的操作的影响将会很大,因为要分出一半的运算能力去执行回收器线程。
2. CMS无法清除浮动垃圾。
浮动垃圾指的是CMS清除垃圾的时候,还有用户线程产生新的垃圾,这部分未被标记的垃圾叫做“浮动垃圾”,只能在下次 GC 的时候进行清除。
3. CMS 垃圾回收会产生大量空间碎片。
CMS 使用的是标记-清除算法,所有在垃圾回收的时候回产生大量的空间碎片。
6. G1 (Garbage-First)
官网: docs.oracle.com/javase/8/do…
特点:
- 分代收集 (仍然保留了分代的概念)
- 空间整合 (整体上属于“标记-整理”算法,不会导致空间碎片)
- 可预测的停顿 (比CMS更先进的地方在于能让使用者明确指定一个长度为M毫秒的时间片段内,消 耗在垃圾收集上的时间不得超过N毫秒)
Region
G1的内存结构和传统的内存空间划分有比较的不同。G1将内存划分成了多个大小相等的Region(默认是512K),Region逻辑上连续,物理内存地址不连续。同时每个Region被标记成E、S、O、H,分别表示Eden、Survivor、Old、Humongous。其中E、S属于年轻代,O与H属于老年代。 示意图如下:
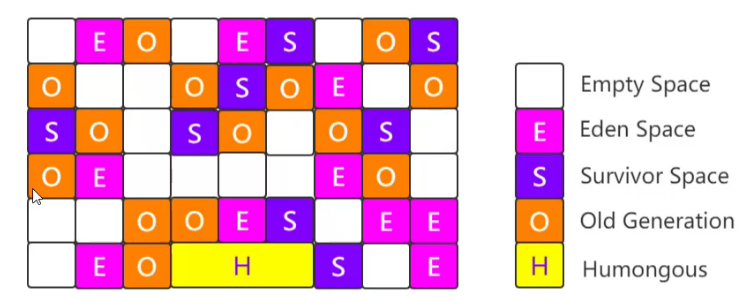
H表示Humongous。从字面上就可以理解表示大的对象(下面简称H对象)。 当分配的对象大于等于Region大小的一半 的时候就会被认为是巨型对象。H对象默认分配在老年代,可以防止GC的时候大对象的内存拷贝。
所有的垃圾回收,都是基于 1 个个 region 的。JVM 内部知道,哪些 region 的对象最少(即:该区域最空),总是会优先收集这些 region(因为对象少,内存相对较空,肯定快),这也是 Garbage-First 得名的由来,G 即是 Garbage 的缩写, 1 即 First。
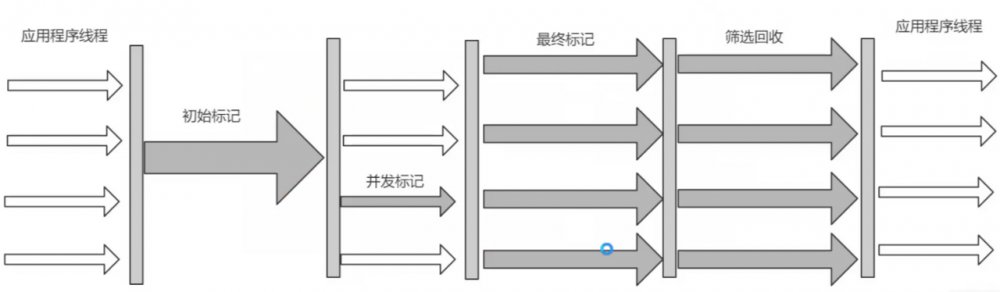
整个过程分为4步:
-
初始标记和 并发标记 的作用与CMS一样
-
最终标记与CMS的重新标记一样 重新标记阶段是为了修正并发期间由于用户进行运作导致的标记变动的那一部分对象的标记记录。这个阶段的停顿时间一般会比初始标记阶段稍长一些,但远比并发标记的时间短,需要 Stop The World 。
-
筛选回收首先对各个 Region 的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。这个阶段可以与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的。这样可能会导致只能回收一部分,有一部分垃圾无法回收掉,只能期待下一次的回收,所以垃圾回收时间不要调的太严格。
G1在JDK7中出现,JDK8可以试用,JDK9默认,但是JDK11又出了个zGC,号称能少于10ms,他希望你的内存越大越好,支持TB级别的。现在商用并不不多。
7. 总结:
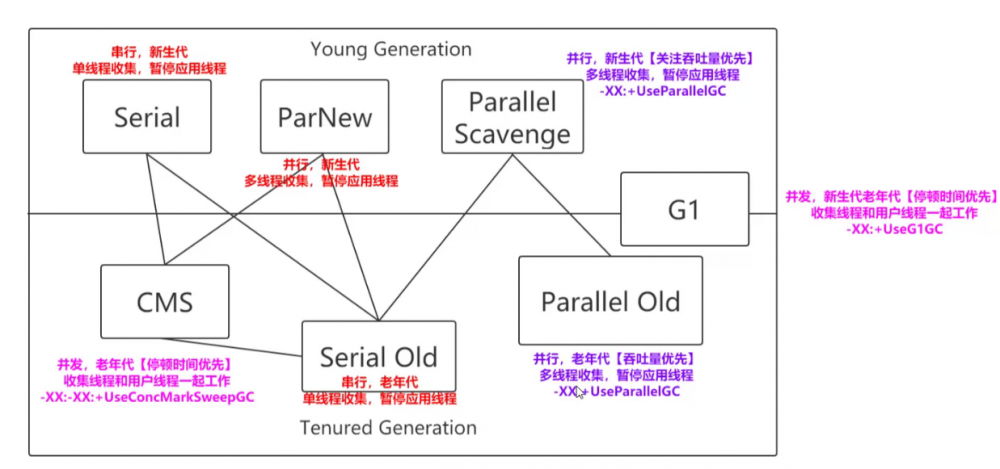
串行收集器:Serial / Serial Old
- 只能有一个垃圾回收线程执行,用户线程暂停
- 适用于内存比较小的嵌入式设备
并行收集器[吞吐量优先]:Parallel Scavenge / Parallel Old
- 多条垃圾收集线程并行工作,但此时用户线程仍然处于等待状态。
并发收集器[停顿时间优先]:CMS / G1
- 用户线程和垃圾回收线程同时执行,一起工作,(但CPU时间片还是有切换的),关注停顿时间,更加适用与有交互的场景,比如说Web
吞吐量和停顿时间也是评价一个垃圾收集器性能好坏的指标。
相关JVM参数:
串行 :
- -XX:+UseSerialGC
- -XX:+UseSerialOldGC
并行(吞吐量优先):
- -XX:+UseParallelGC
- -XX:+UseParallelOldGC
并发收集器(响应时间优先) :
- -XX:+UseConcMarkSweepGC
- -XX:+UseG1GC
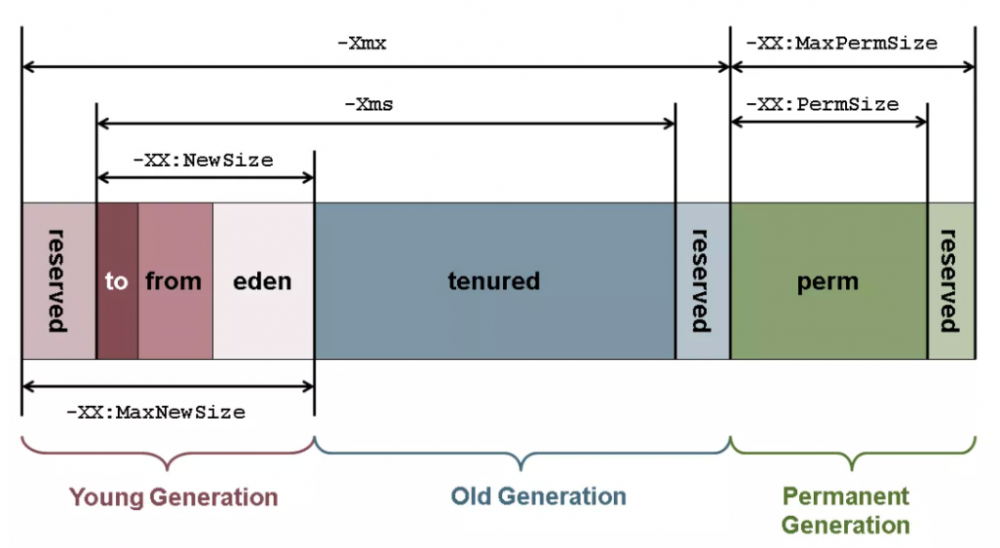
注:jdk8 开始,用 MetaSpace 区取代了 Perm 区(永久代),所以相应的 jvm 参数变成 -XX:MetaspaceSize 及 -XX:MaxMetaspaceSize。
如何选择合适的垃圾收集器?
一般情况下, 不需要选择 ,如果不满足需求,可以 调节堆的大小 ,如果还不行,那就按下面这种方式:
●If the application has a small data set (up to approximately 100 MB), then select the serial collector with the option -XX: +UseSerialGC. ●If the application will be run on a single processor and there are no pause time requirements, then let the VM select the collector, or select the serial collector with the option -XX : +UseSerialGC ●If (a) peak application performance is the first priority and (b) there are no pause time requirements or pauses of 1 second or longer are acceptable, then let the VM select the collector, or select the parallel collector with -XX:+UseParallelGC. ●If response time is more important than overall throughput and garbage collection pauses must be kept shorter than approximately 1 second, then select the concurrent collector with XX:+UseConcMarkSweepGC or ``-XX:+UseG1GC`.
正文到此结束
热门推荐




相关文章



Loading...


